 一番怖い瞬間は、セーフルームを出る直前だ。
このブログサイトの実装の流れについて
空のリポジトリから完成まで ── 実装の流れ(フェーズ0〜8)
最初に計画書を書き、そこにフェーズを切って進めました。ただ、実際の実装は計画とぴったり同じにはなりませんでした。計画と現実の一番大きな違いを先に言ってしまうと ── 計画書はフェーズ7までで、音声・動画は「後回し」に分類されていました。ところが実際にはフェーズ8を追加して、音声・動画まで作り切りました。
フェーズ0 ── 土台づくり
まず骨組みです。
git init、GitHubリポジトリ作成。- pnpm workspaces + Turborepo を立ち上げ、
apps/web・apps/console(どちらもNext.js 16 / App Router / TypeScript)、packages/db・packages/contentを空の状態でスキャフォールド。 - 共有の tsconfig / ESLint / Prettier、
turbo run build|dev|lintの配線。 - アプリごとの
.env.example。
フェーズ1 ── データベースと共有パッケージ
土台の次は、プロジェクトの心臓部です。
packages/db:Drizzleで全テーブルのスキーマを定義し、マイグレーションを生成してSupabaseに適用。ストレージバケットのポリシーもマイグレーションで管理。- シードスクリプト:翻訳・タグ・画像・リンクを持つサンプル記事を数本投入。
packages/content:Markdownパイプライン、ショートコードのレジストリ、Reactの描画コンポーネント(CSS Modules)。
ここで、後の全機能が乗る2本の柱 ── 「型付きのデータ層」と「共有の本文レンダリング」 ── が立ちました。この2つを最初に固めたことが、後半をずっと楽にしました。
フェーズ2 ── コンソール:認証と記事CRUD
記事の編集側を作り始めます。
- Supabase Auth(GitHub OAuth)。ミドルウェアで、セッションのメールが
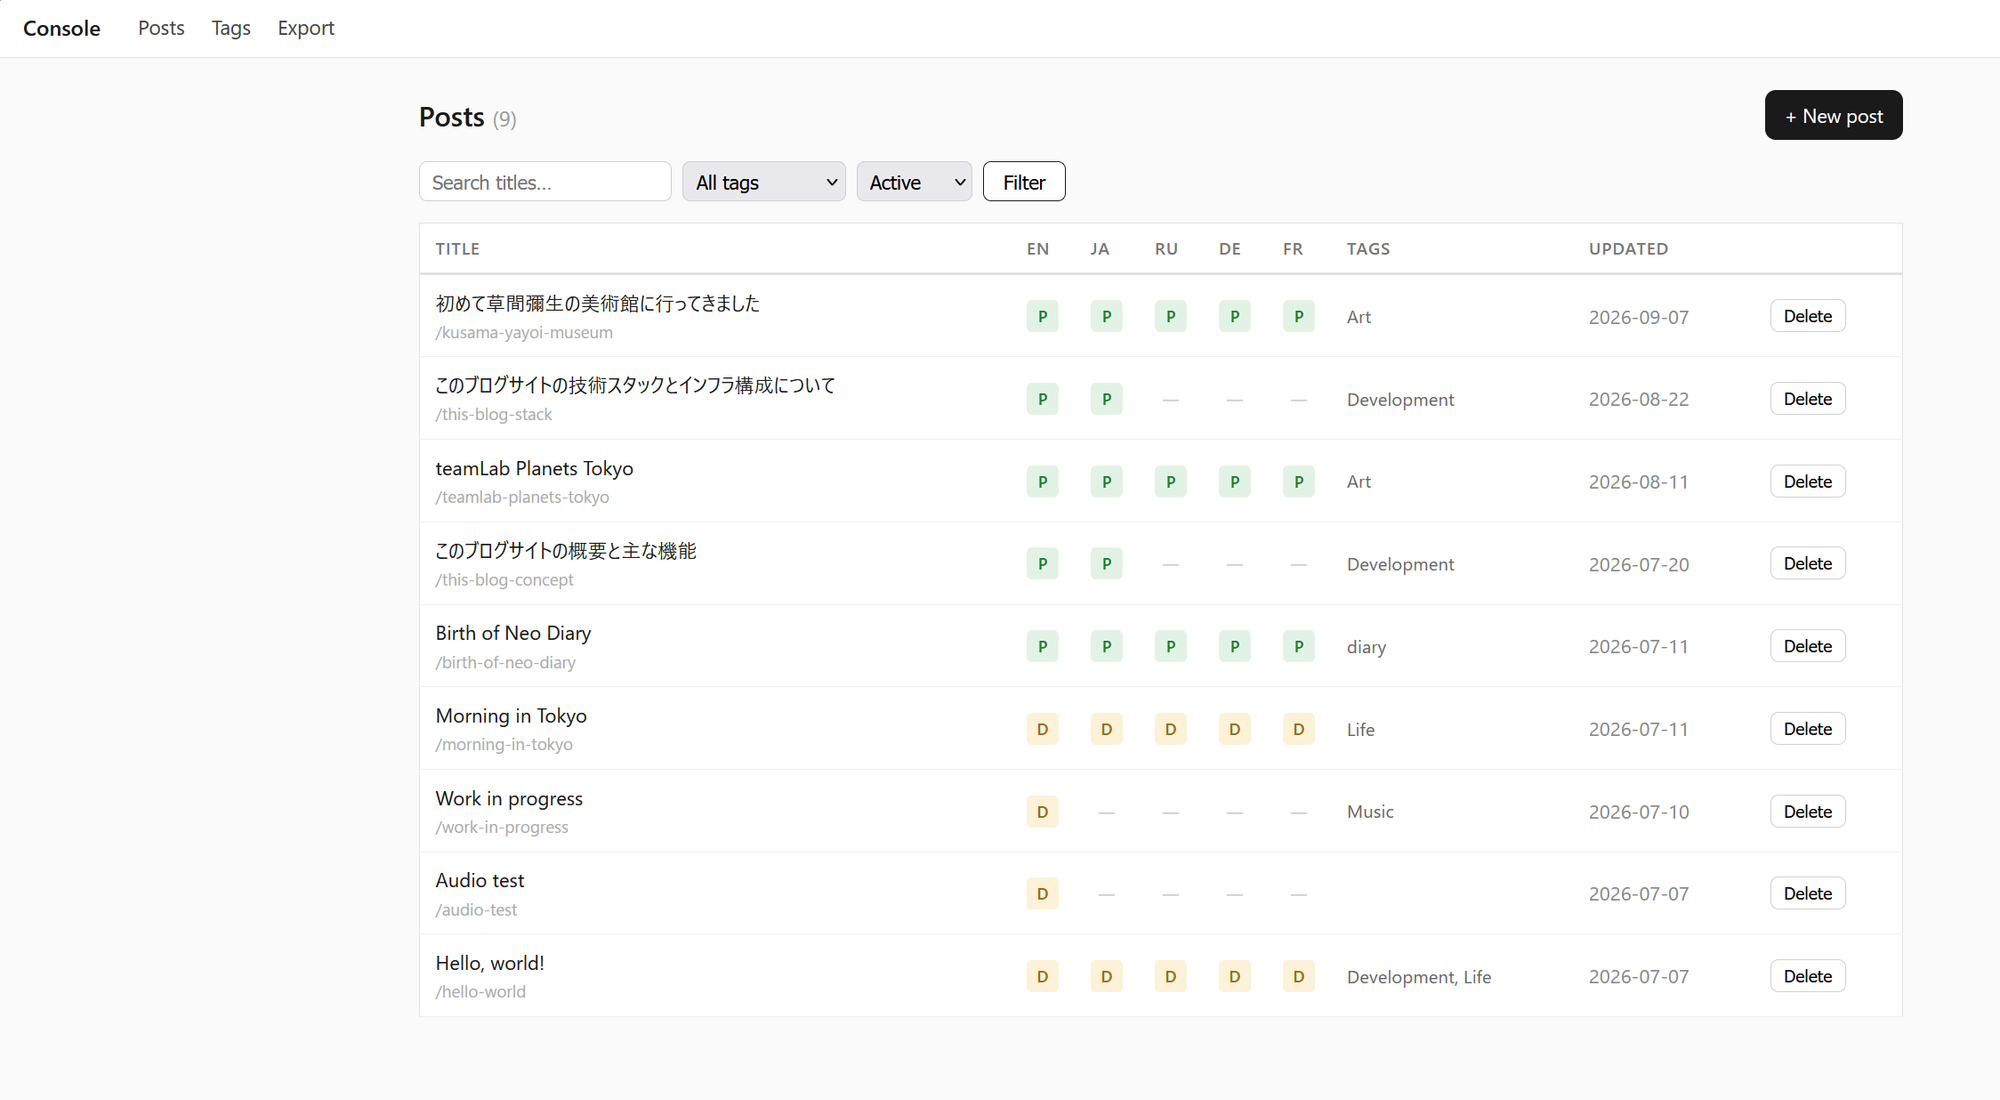
ADMIN_EMAILと一致しないセッションを弾く。コンソールの全ルートを保護。 - 記事一覧:ページング、5言語分のステータス表示(言語ごとに「下書き/公開済み/未作成」)、タイトル検索、タグ絞り込み、確認付きの論理削除と復元。
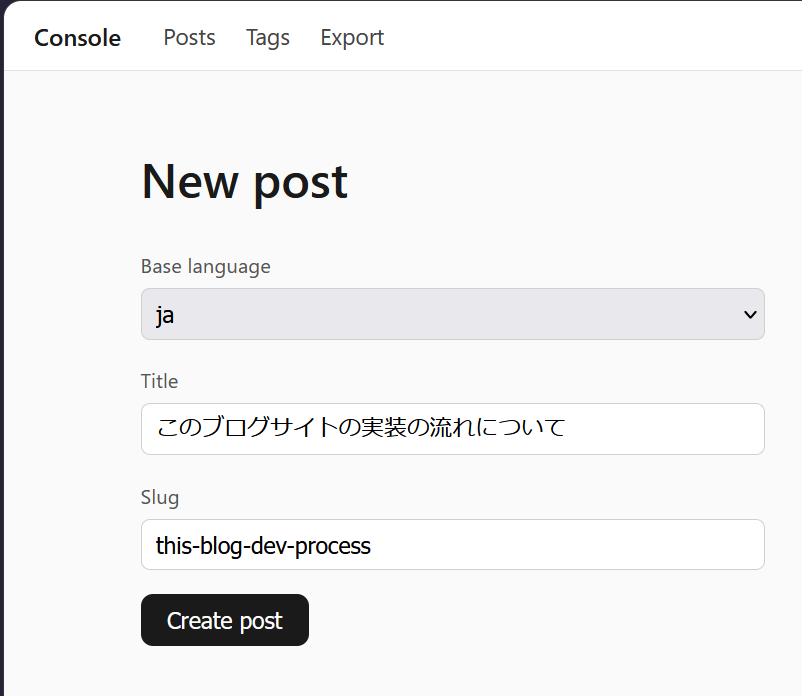
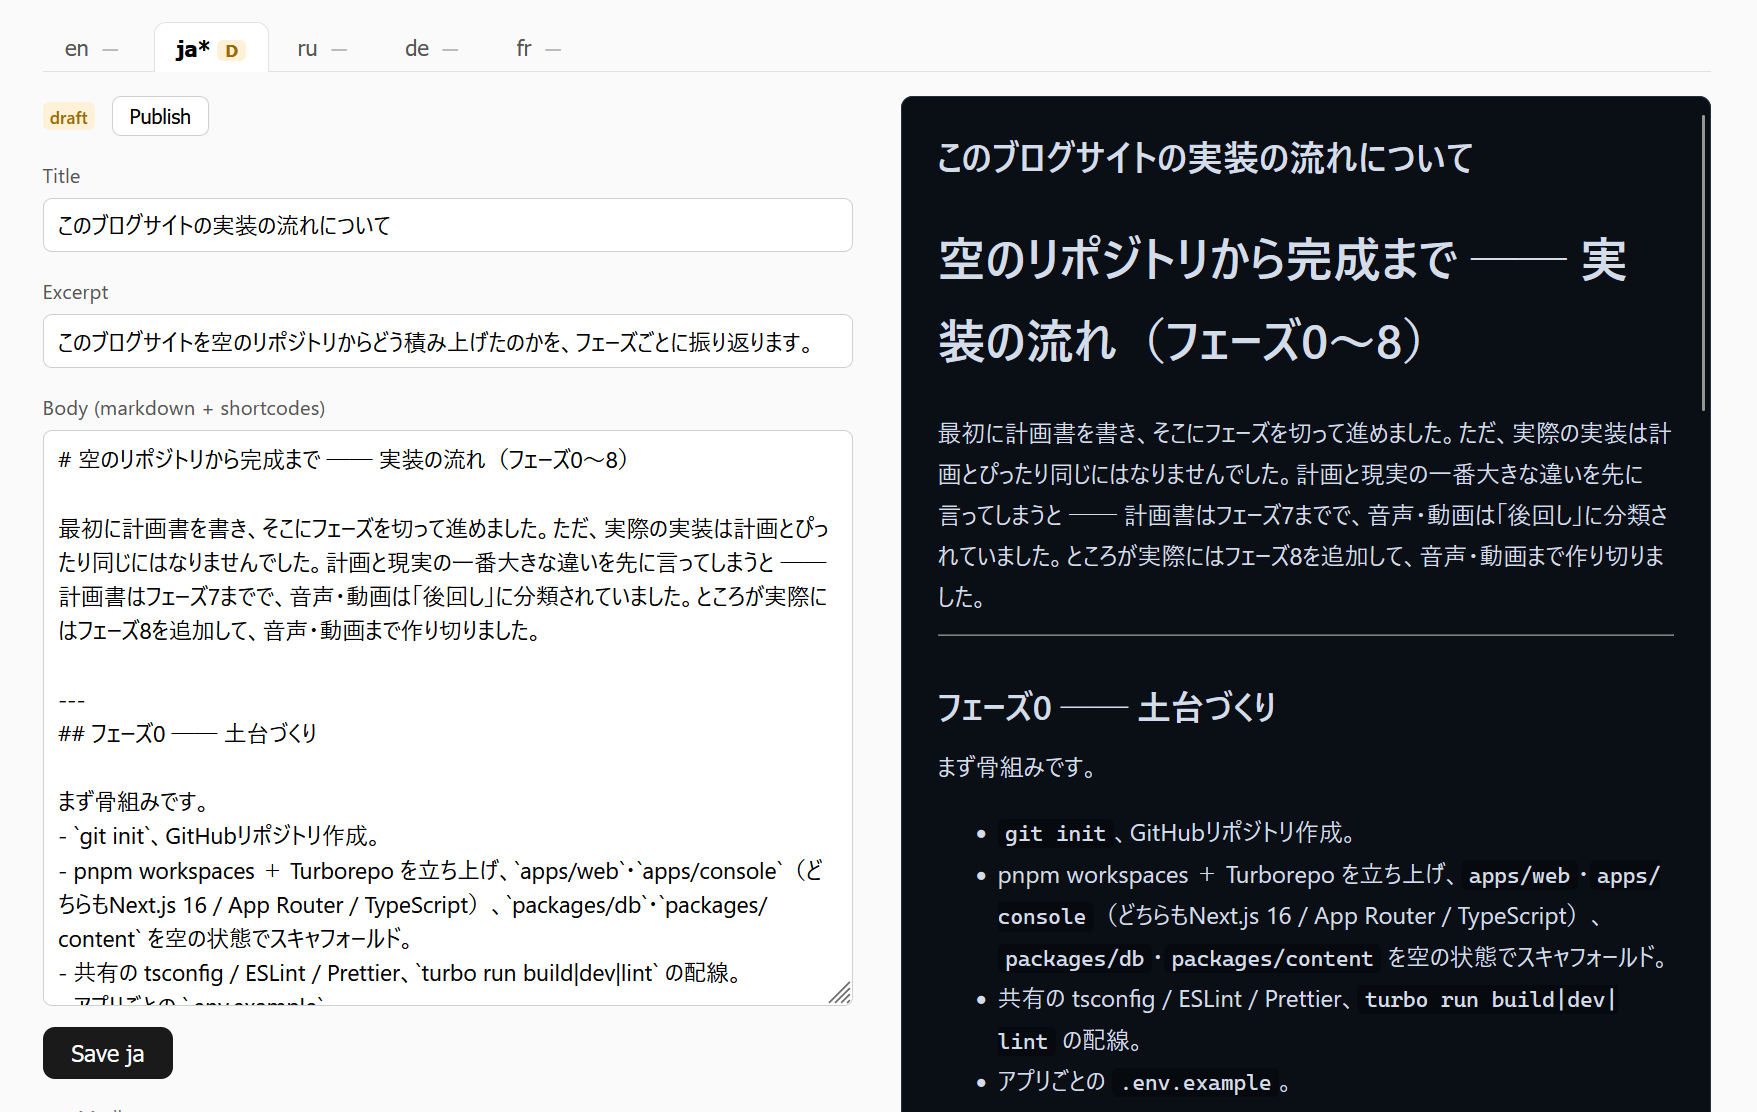
- 記事エディタ:ベース言語の選択、スラッグ(タイトルから自動生成・編集可)、Markdownテキストエリア+ライブプレビュー(
packages/contentの描画をそのまま使うので、プレビュー=公開後の姿)。言語タブで各翻訳を独立して下書き/公開。
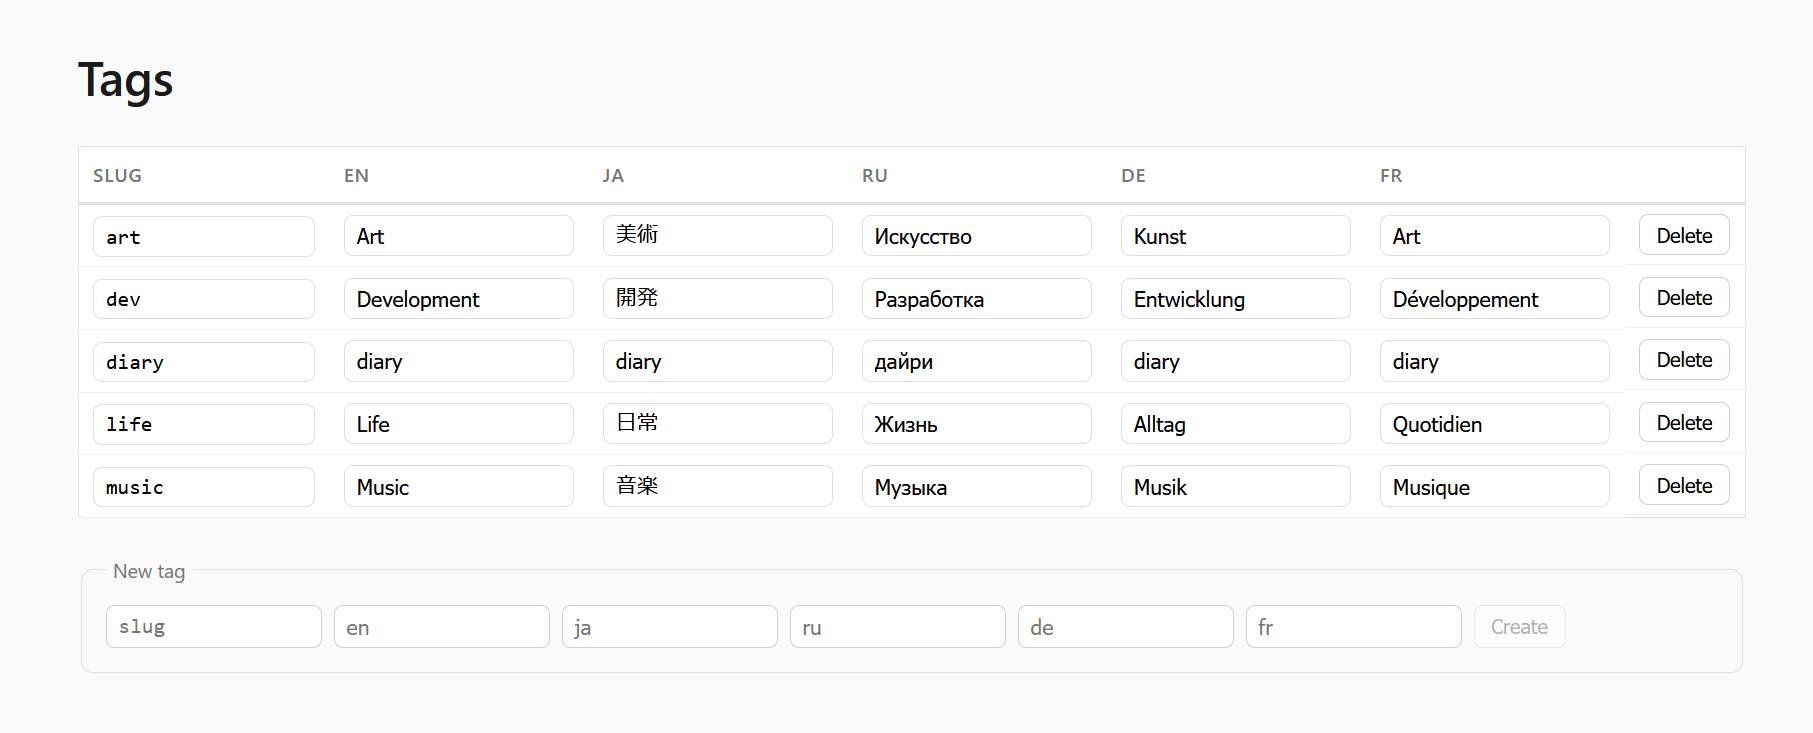
- タグ管理(言語別の名前)、記事ごとのリンク管理。
フェーズ3 ── コンソール:アップロード
記事に画像を入れられるようにします。
- サーバー側のアップロードルート:複数ファイル受付、jpeg/png/gif/pdf対応。
- 画像は sharp で処理:長辺を2000pxに抑え、EXIF(回転を適用してから)を除去、約400pxのサムネイル生成。
- ファイルは中身をデコードして検証(拡張子を偽装した
.txtは弾く)。 - MIMEタイプで処理を振り分ける ── この分岐点が、後で「音声・動画」を足す拡張ポイントになりました。
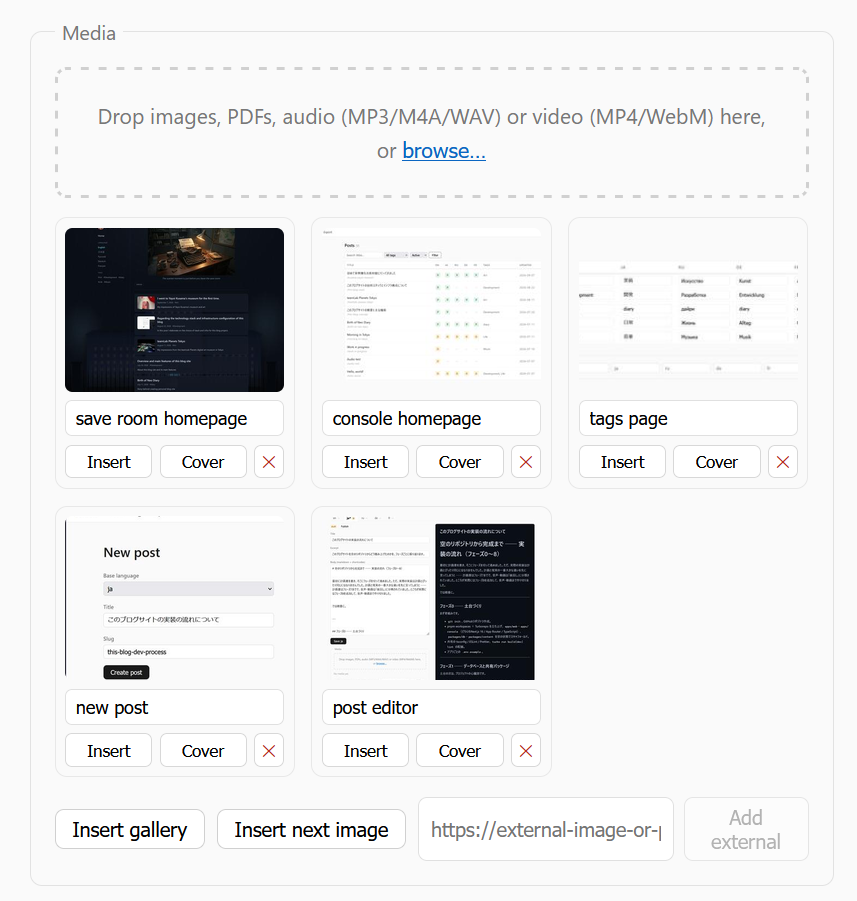
- エディタのメディアパネル:ドラッグ&ドロップ複数アップロード、進捗付きサムネイルグリッド、altテキスト、並べ替え、削除(ストレージ実体も消す)、本文への「挿入」ボタン。
- カバー画像の選択。
このフェーズで「MIMEで振り分ける」という設計を選んだことが、後のフェーズ8への伏線になります。
フェーズ4 ── コンソール:機械翻訳
多言語ブログの本丸です。
- Google Cloud Translation v3 のクライアント(RESTを直叩き、サービスアカウント認証)をサーバーアクションで包む。
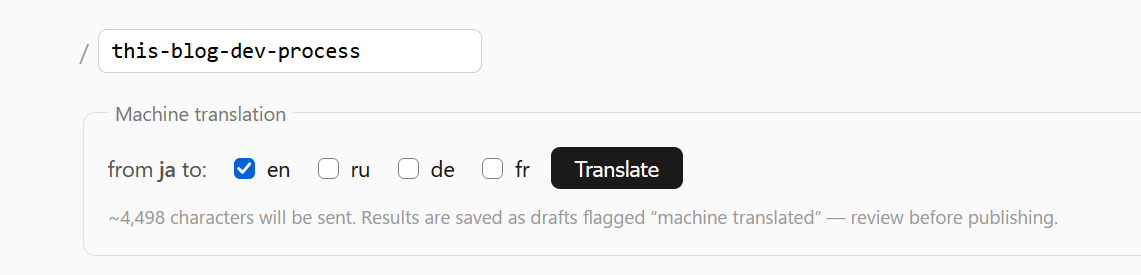
- エディタに翻訳UI:ソースはベース言語、ターゲットは残り4言語の任意の組み合わせをチェックボックスで。
- 翻訳フロー:ショートコード・コード・URLをマスキング → タイトル・抜粋・本文を翻訳 → アンマスク →
is_machine_translated = true/status = draftで保存。 - 機械翻訳を手で編集するとフラグは残しつつ
edited_atを打つ。「再翻訳(編集を上書き)」は確認を要求。 - リクエストごとの文字数表示(無料枠50万文字/月を意識するため)。
確認できたこと: コードブロック・ショートコード・リンクを含む英語記事を日本語とドイツ語に翻訳しても、構文とショートコードが無傷のまま。マスキングの設計が実際のAPI相手に機能することを確かめられました。
フェーズ5 ── 公開サイト:コア
ここでようやく、読者が見る側を作ります。
- next-intl の設定:ロケールは
packages/dbから取得。「URLのロケール優先 → Accept-Language → 英語」の判定。言語切替は現在のパスを書き換える。 - レイアウト(CSS Modules、モバイルファースト):サイドバー(アバター・言語切替・タグ一覧、スマホではドロワーに)、ヘッダー(タイトル・入れ替わる引用句)、フッター。
- 記事一覧
/{locale}:その言語で公開済みの記事だけ、ページング付き。 - 記事ページ
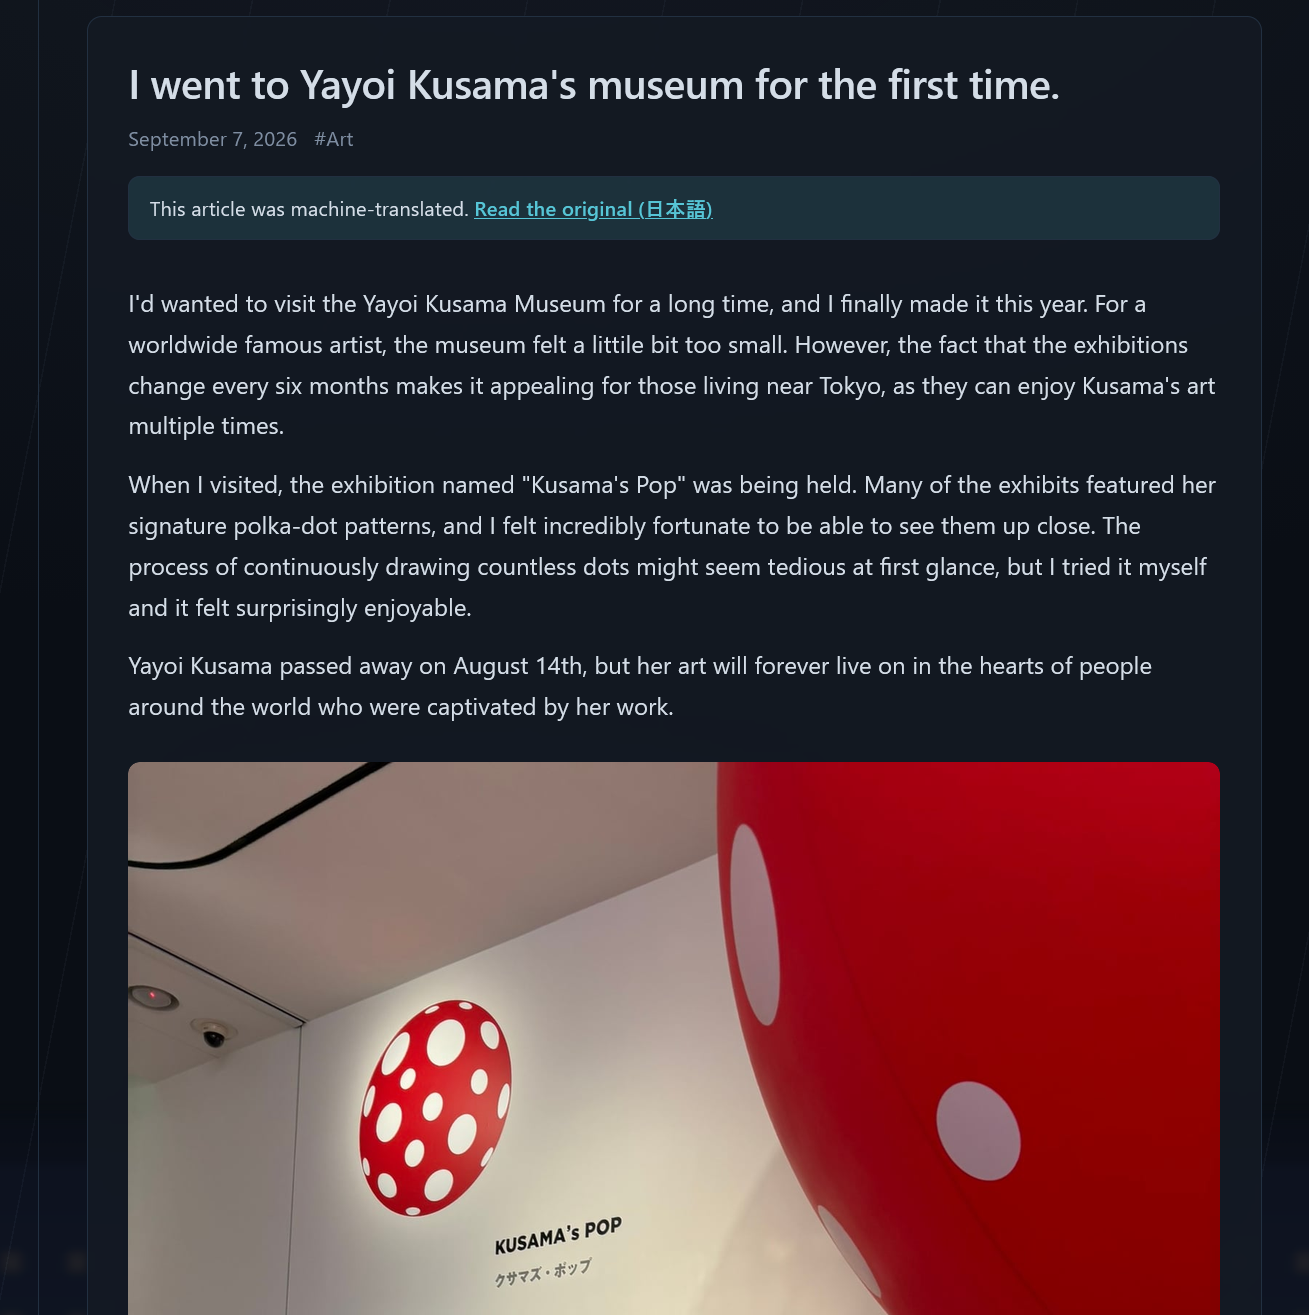
/{locale}/posts/{slug}:packages/contentでフル描画。画像(Supabaseホストも外部URLも)、{{gallery}}のEmblaカルーセル、タイムスタンプ付きYouTube、PDF、言語別リンク、機械翻訳バッジ+原文リンク。
- タグページ
/{locale}/tags/{slug}。 - 描画戦略はISR。コンソールが公開/更新のたびに秘密鍵付きの再検証エンドポイントを叩いて即時反映、フォールバックとして1時間ごとの再検証。
フェーズ1で作った共有レンダリングがここで効いてきます。コンソールのプレビューと公開サイトが同じコードで描かれるので、「プレビューでは見えていたのに本番で崩れる」がありません。
フェーズ6 ── 公開サイト:SEOと配信
見えないところの作り込みです。
- すべてのページに
hreflang代替リンク(実際にその言語で公開されている言語だけ)+x-default。 - hreflang代替リンクを埋め込んだサイトマップ、robots.txt。
- OGP/Twitterメタ:カバー画像、なければ
next/ogでその場生成する1200×630のタイトルカード。日本語・キリル文字のタイトルもちゃんと出るよう、タイトルに合わせてGoogle Fontsのサブセットを読み込む。 - 言語別のRSSフィード(
/{locale}/feed.xml)。
Next.jsのメタデータは上位キーを「マージ」ではなく「置換」する、という挙動にハマったので、各ページで言語別RSSリンクを毎回指定し直す、という小さな工夫がこのフェーズに残っています。
フェーズ7 ── 運用:デプロイ・バックアップ・アーカイブ
「作る」から「運用する」への切り替えです。
- モノレポから2つのVercelプロジェクト、環境変数の設定。
- エクスポート:全テーブルJSON+全ファイルのZIPを出すコンソールアクション(引っ越し用の脱出ハッチ)と、既定でロールバックするdry-run復元スクリプト。
- 自動バックアップ:GitHub Actionsで週次
pg_dump、非公開バケットへアップロード、直近8世代を保持。
フェーズ8 ── 音声・動画(最初の計画書では「後回し」だったもの)
- Cloudflare R2 を導入(S3互換、下り課金ゼロ)。
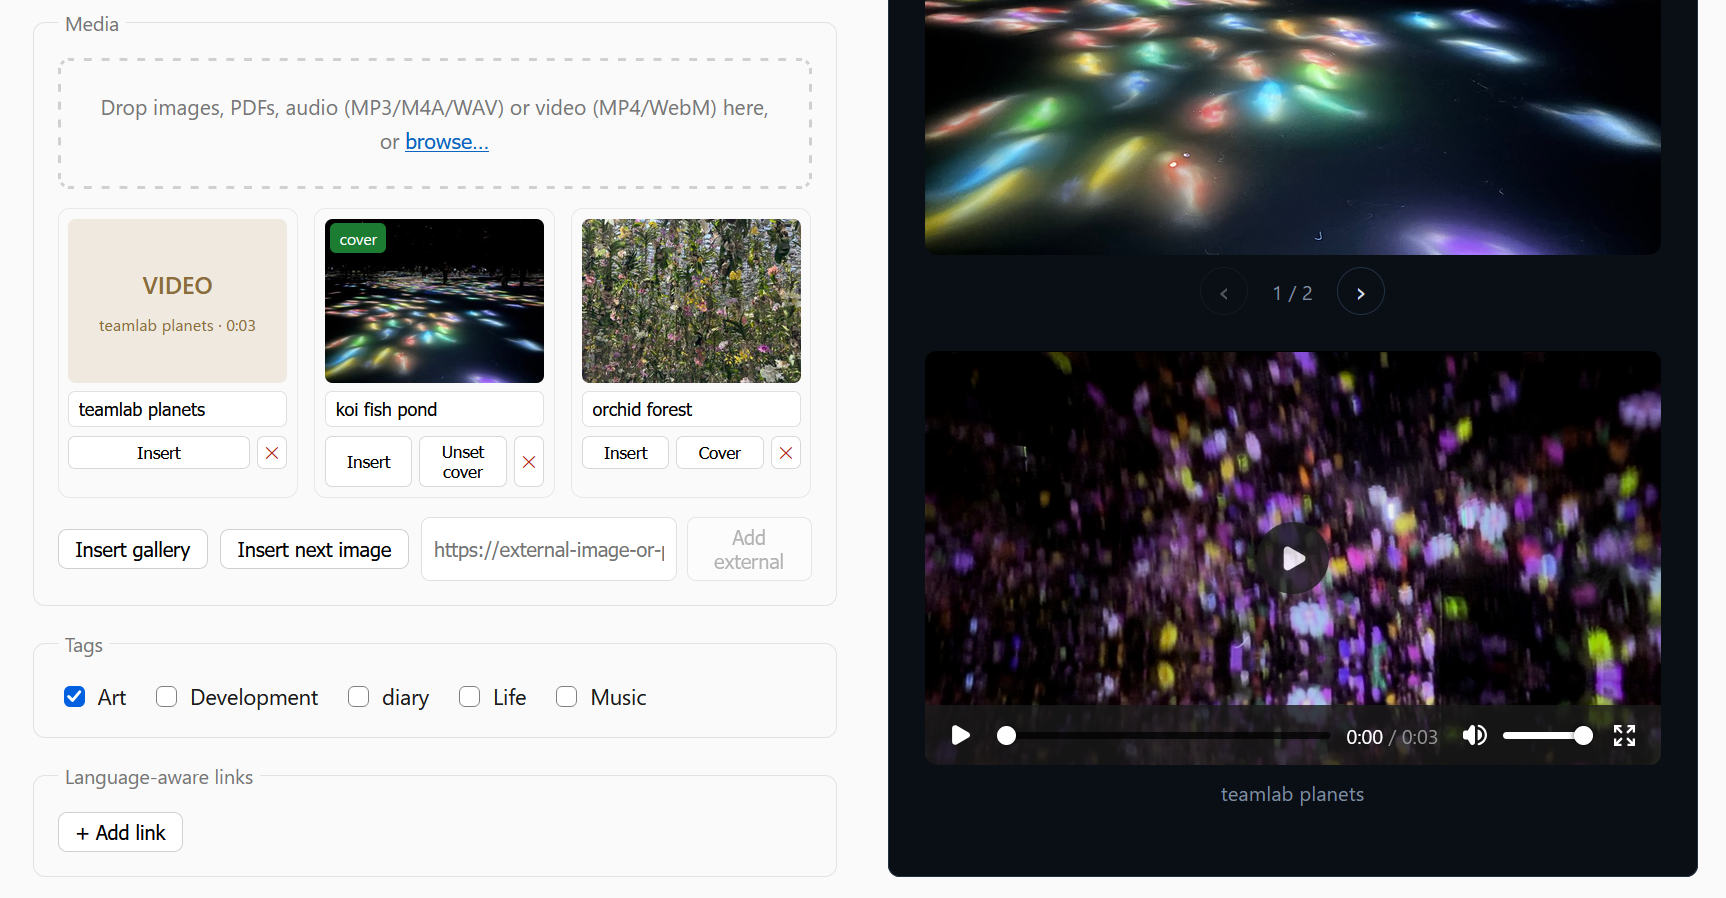
- 署名付きPUT URLを発行し、ブラウザから直接R2へ音声・動画をアップロード(大きなファイルがサーバーを通らない)。再生時間や解像度はアップロード前にブラウザ側で読み取る。
{{audio}}/{{video}}ショートコードと、自作のオーディオ/ビデオプレイヤー(ネイティブ<audio>/<video>の上に)。- ブラウザが実際に再生できる形式だけを受け付ける割り切り(音声はMP3/M4A/AAC/WAV/OGG/FLAC、動画はMP4(H.264/AAC)かWebMのみ。iPhoneの
.mov/HEVCは変換が必要)。
- エクスポートにも音声・動画を含めるよう対応。
そして、ここでフェーズ3の設計が報われます。フェーズ3で「アセットの kind はただのtext、詳細は metadata(JSONB)、処理はMIMEで振り分け」という形にしておいたおかげで、音声・動画を足すのにデータベースのマイグレーションは1本も要りませんでした。新しいストレージ先(R2)を足し、MIME分岐に枝を1本生やし、ショートコードのレジストリに描画を2つ登録する ── それだけで済んだのです。
計画の時点で「後回し」に分類していたものを、将来足せる形にきちんと設計してから見送っていた。だから気が変わって「やっぱり作ろう」となったとき、破壊的な変更なしに乗せられた。個人的には(Claudeによると)、これがこのプロジェクトで一番うまくいった判断でした。